 AIでクリエイティブをもっと身近に
-
画面録画
-
動画・音声
-
PDF
-
AIツール
-
オンラインツール
-
会社情報
AIでクリエイティブをもっと身近に 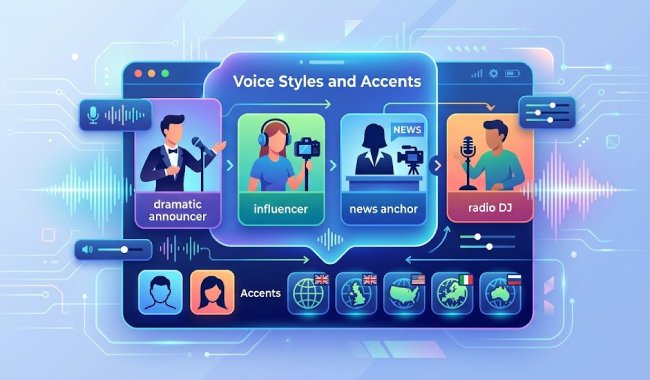
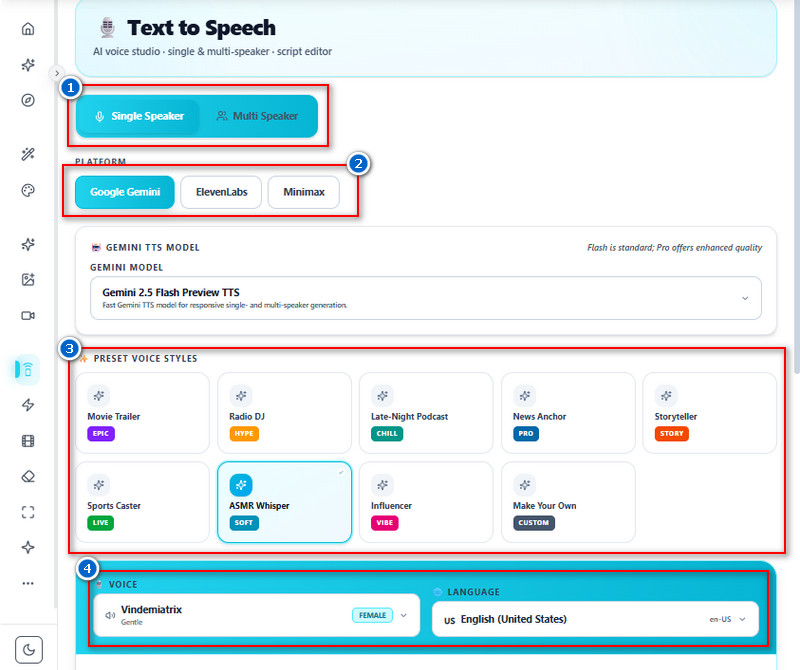
オンラインのテキスト読み上げでは、内容や雰囲気に合う多彩な音声スタイルを選べます。映画予告、インフルエンサー、ラジオDJ、ニュースキャスターなど、制作物に応じたスタイルを利用できます。男性・女性音声の切り替えやアクセントの選択にも対応し、対象者や台本に合う自然で親しみやすい音声を作れます。プロの声優に依頼せず、魅力的な音声コンテンツを制作できます。
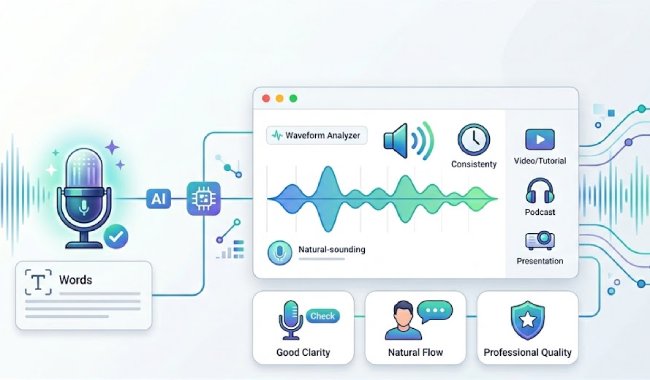
自然で滑らか、聞き取りやすい音声を生成します。AIが機械的な響きを抑えて明瞭さを高めるため、人間らしい声に仕上がります。音質が重要な動画、チュートリアル、プレゼン、ポッドキャストに便利です。追加編集なしでも魅力的でプロらしいコンテンツを作れ、短い台本から長い台本まで安定した品質で出力します。視聴体験を高め、内容を理解しやすくできます。
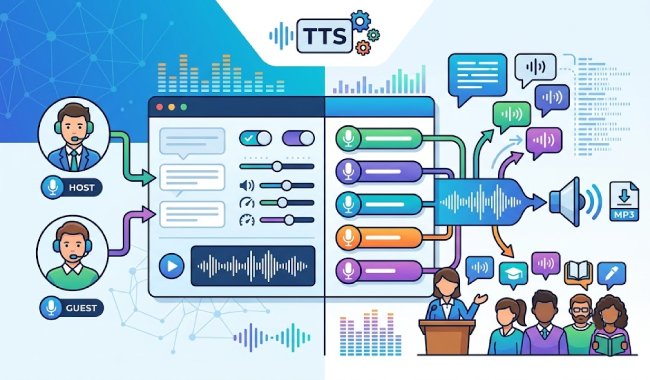
一つの音声作品で複数の声を使い、インタビュー、物語、研修、教育コンテンツを作成できます。司会者とゲストなど、台本の各部分を別の話者に割り当てられます。声ごとに特徴を変えられるため、会話をより自然で魅力的に表現できます。複数回の録音や外部の声優は不要で、少ない手間で変化に富んだコンテンツを作れます。
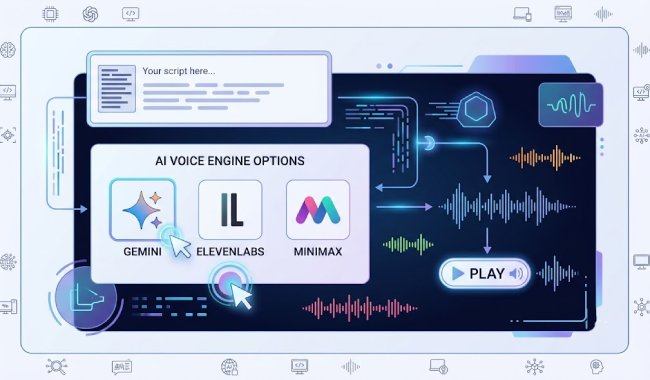
Gemini、ElevenLabs、MiniMaxなどのAI音声エンジンを一つの画面から利用できます。各エンジンには独自のスタイル、声色、品質があり、好みに応じて選べます。制作物ごとに提供元を切り替えて最適な声を探せるため、複数のツールを使わずに品質と表現の幅を高められます。自然さやプロらしさを比較しながら、無料のテキスト読み上げで音声生成を柔軟にカスタマイズできます。

さまざまなコンテンツの視聴体験を高める クリアで自然、聞き取りやすい音声を生成します。

文章をわずか 数 分で音声に変換し、コンテンツ制作の時間を節約します。

音声生成で 複数の 言語に対応し、世界中の視聴者向けコンテンツを簡単に作成できます。
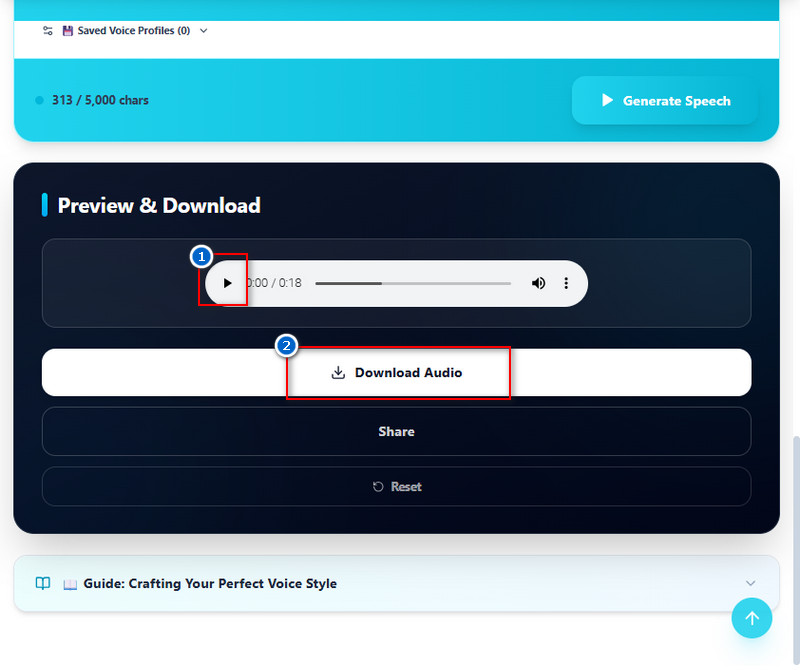
TTS(テキスト読み上げ)は、AIを使って文章を音声へ変換します。まず文章を読み取り、単語、文、句読点を解析します。続いて言語規則に基づいて発話音を生成する音声モデルで処理します。AIが自然な声色、リズム、間も加えるため、聞き取りやすい音声になります。処理後は、再生またはダウンロードできる音声ファイルが生成されます。これにより、文章を読むだけでなく耳で聞けるようになります。
適切な音声は、コンテンツの種類と対象者によって異なります。本ツールでは、さまざまな音声スタイル、アクセント、男性・女性音声から用途に合わせて選べます。教育やビジネス向けには明瞭で中立的な声、創作やSNS向けには表現豊かで印象的な声が適しています。最終音声を生成する前に複数の候補を試聴すると、メッセージと目的に合う声を選べます。
米国・英国英語、スペイン語、フランス語、ドイツ語、ヒンディー語、日本語、韓国語など、多くの主要言語に対応しています。地域や対象者に合わせた音声コンテンツを作成でき、各言語には明瞭な発音を実現する自然な音声モデルが用意されています。別のツールへ移動せず、用途に応じて言語を切り替えられます。更新により対応言語が追加される場合もあり、一つの画面から世界向けコンテンツを作りやすくなります。
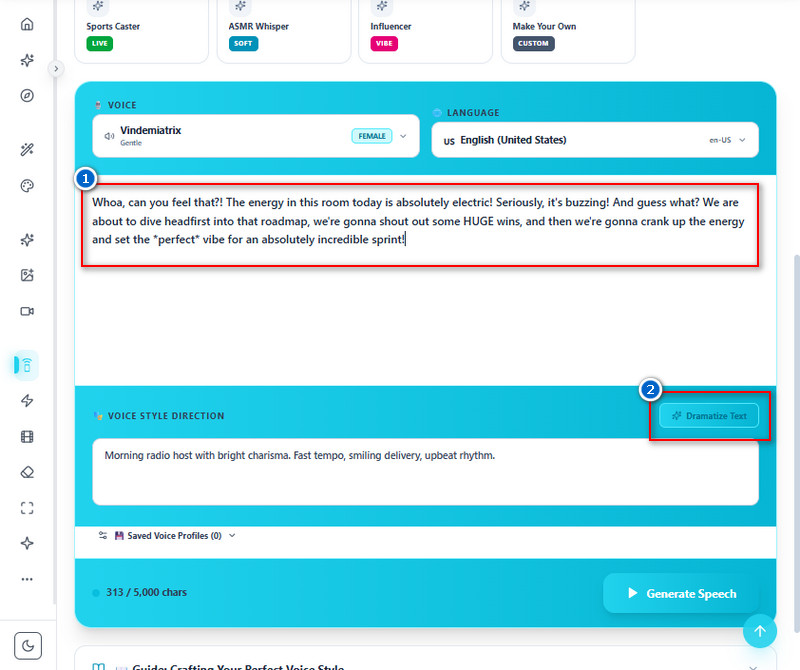
はい。初心者向けに設計されており、専門知識は不要です。入力欄へ文章を貼り付けるか入力し、音声を選んでボタンをクリックするだけで生成できます。画面は分かりやすく、複雑な設定もありません。初めてでも数分で手順を理解でき、学生、制作者、ビジネス利用のいずれにも適しています。
はい。1回の変換につき最大5,000文字まで入力できます。この上限により、音声を安定してエラーなく処理できます。長い内容は複数の短い部分に分けて変換し、必要に応じて後から一つの音声ファイルへ結合できます。台本、記事、プレゼンも扱いやすく、処理性能と出力品質を保つための制限です。





 AceThinker Wind Cut